Nehmen wir eine Spedition aus dem Norden. Seit drei Jahren betreibt sie ein Kundenportal. Dort legen Verlader Transportaufträge an und sehen, wo ihre Sendung gerade ist. Jetzt fragt der größte Kunde, ein Versandhändler, ob sein Lagerverwaltungssystem die Aufträge direkt schicken kann, statt dass jemand sie abtippt.
Die Antwort aus der Entwicklung: Eine Schnittstelle gibt es, aber sie ist mit tRPC gebaut und nur für das eigene Portal gedacht. Also muss eine zweite her.
Falsch programmiert hat niemand. Die Technik wurde nur für eine andere Frage ausgesucht: Wie redet unser Frontend mit unserem Server? Jetzt lautet die Frage: Wie redet eine fremde Firma mit uns? Solche Fehlgriffe sehen wir in Projekten immer wieder. Deshalb hier die Übersicht: welche Transporte es gibt, was jeder gut kann und wie du dich entscheidest.
Was ein Transport festlegt
Wenn zwei Programme Daten austauschen, brauchen sie gemeinsame Regeln. Wie sieht eine Anfrage aus? Kommt die Antwort als lesbarer Text oder als kompakte Binärdaten? Und wo steht, welche Felder es gibt?
Dieses Regelwerk ist der API-Transport. Für die Leute am Bildschirm sieht das Ergebnis immer gleich aus. Für drei Dinge macht die Wahl aber einen großen Unterschied: wer sich später an die Schnittstelle anschließen kann, wie viel Last sie trägt und wie viel Code ihr pflegen müsst.
Fünf Transporte und ihre Stärken
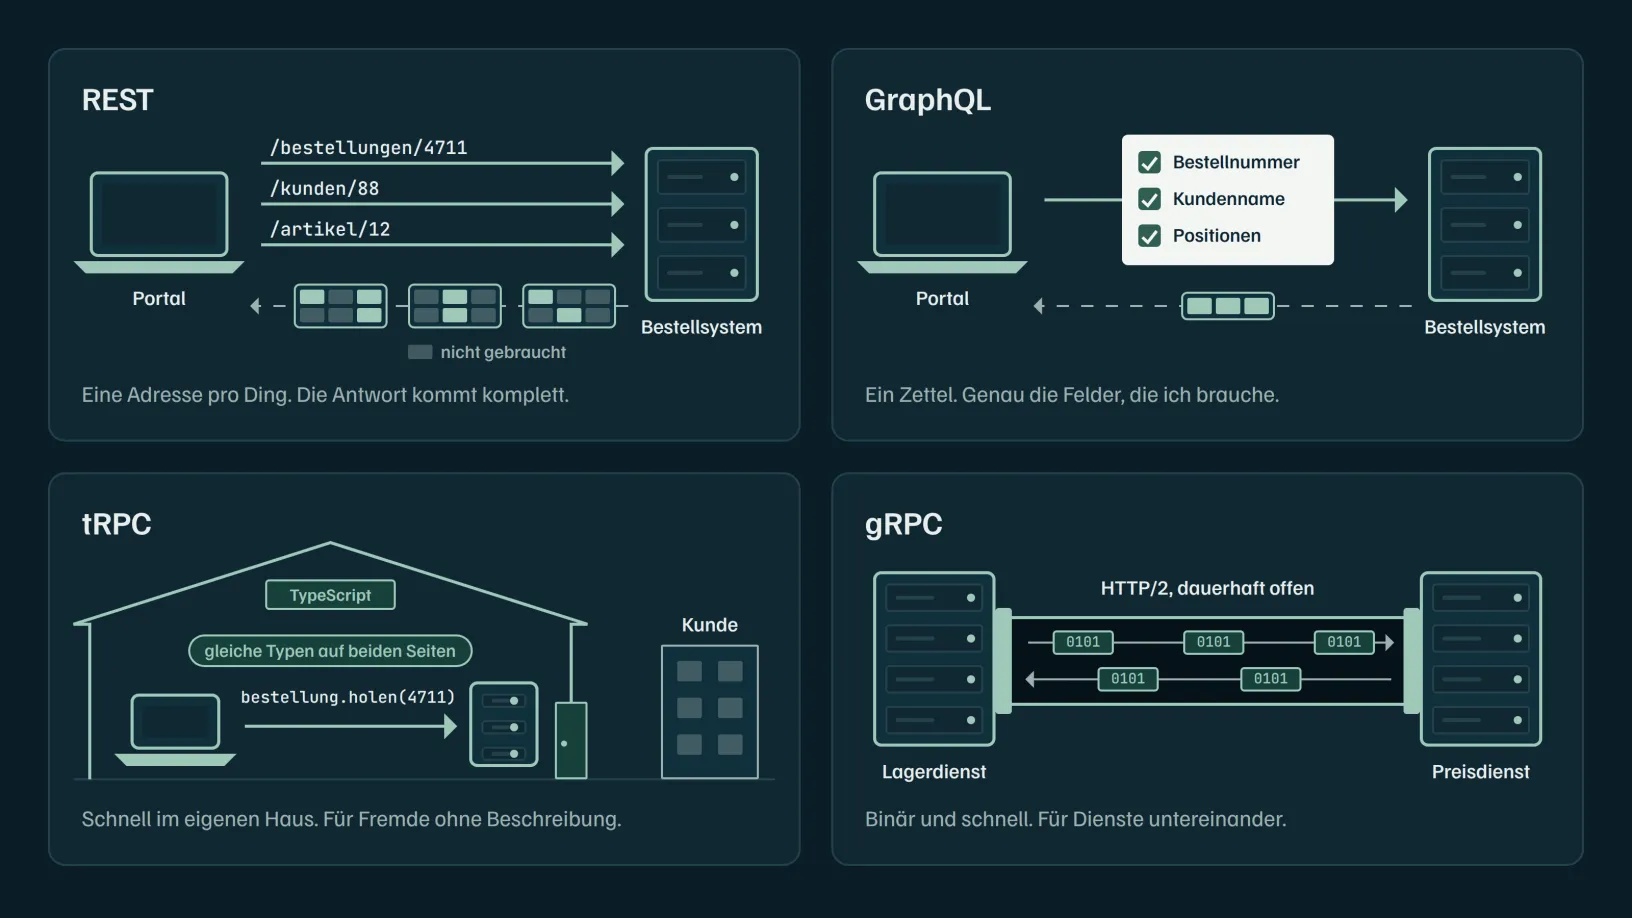
REST ist der Standard. Jedes Ding hat eine eigene Adresse, etwa „Sendung 4711“, und die Antwort kommt als Text im JSON-Format. 93 % der Softwareteams nutzen REST. Die Schnittstellen sind zustandslos, und Antworten lassen sich zwischenspeichern. Die Schwäche: Der Client bekommt, was die Adresse liefert. Braucht er mehr, fragt er mehrmals. Braucht er weniger, bekommt er trotzdem alles.
GraphQL ist entstanden, um genau diese Ineffizienz zu beheben. Es gibt eine Adresse, und der Client schreibt in die Anfrage, welche Felder er haben will. Über die sogenannte Introspection beschreibt die Schnittstelle selbst, was sie kann. Der Preis ist mehr Werkzeug: Die Typen im Frontend entstehen meist per Code-Generierung, und die erzeugten Dateien werden schnell sehr groß.
tRPC passt, wenn Frontend und Server in TypeScript geschrieben sind und im selben Code liegen. Das Frontend ruft Funktionen auf dem Server auf, als lägen sie im selben Programm. Den Vertrag zwischen beiden bildet kein eigenes Dokument, sondern der Code des Servers selbst. Daraus liest das Frontend ab, welche Funktionen es gibt und welche Felder zurückkommen.
Benennt jemand auf dem Server ein Feld um, zeigt der Editor den Fehler im Frontend sofort. Das Team von Echobind hat ein Projekt von GraphQL auf tRPC umgestellt und dabei netto 1.608 Zeilen Code gestrichen. Das GraphQL-Bundle im Browser war mit 81,2 kb etwa 3,5-mal so groß wie das von tRPC mit 23,7 kb.
Dieser Vorteil hat eine Bedingung: Der Aufrufer muss den TypeScript-Code des Servers mitbenutzen. Das Lagerverwaltungssystem eines Kunden tut das nie. Es stammt von einem anderen Team, oft in einer anderen Sprache, und euer Code bleibt bei euch. Für dieses Team gibt es nur ein Format, das tRPC für sich selbst festlegt, und keine Beschreibung, die es nachlesen könnte. Echobind nennt tRPC deshalb weniger geeignet für öffentliche Schnittstellen. Genau daran hängt die Spedition.
gRPC ist für Gespräche zwischen Diensten gebaut und bei Microservices beliebt. Statt Text schickt es Binärdaten im Format Protocol Buffers über HTTP/2 und hält die Verbindung offen. In Experimenten von Toptal war gRPC bei kleinen Nachrichten 77 % schneller als REST und brauchte unter hoher Last 26 bis 32 % weniger CPU. Dafür setzen es nur 14 % der Teams ein. Und Binärdaten kann niemand mal eben im Klartext mitlesen.
SOAP ist der Älteste in der Runde. Die Nachrichten sind XML, die Regeln streng, und REST ist deutlich flexibler. Für eine neue Schnittstelle spricht deshalb wenig dafür. Verlangt aber die Gegenseite SOAP, stellt sich die Frage nicht.
| Transport | So redet er | Passt gut für | Passt schlecht für |
|---|---|---|---|
| REST | Text (JSON), eine Adresse pro Ding | Partner, Kunden, öffentliche Schnittstellen | viele kleine Aufrufe unter hoher Last |
| GraphQL | Text, eine Adresse, Client wählt die Felder | viele Apps mit unterschiedlichem Datenbedarf | ein Frontend mit überschaubaren Daten |
| tRPC | Funktionsaufrufe, Typen aus dem Server-Code | eigenes Frontend, das den Server-Code mitbenutzt | jede Software, die euren Code nicht hat |
| gRPC | Binärdaten über HTTP/2 | eigene Dienste untereinander, viel Last | Partner, die es nicht kennen (nur 14 % nutzen es) |
| SOAP | XML, strenge Regeln | Gegenseite verlangt SOAP | neue Schnittstellen |
Nicht jede Anfrage braucht sofort eine Antwort
Alle fünf arbeiten synchron: Der Aufrufer fragt und wartet, bis die Antwort da ist. Wie bei einem Telefonat. Daneben gibt es asynchrone Kommunikation über Warteschlangen (Queues) oder Ereignisse (Events). Der Sender legt eine Nachricht ab, der Empfänger holt sie, wenn er so weit ist. Wie bei einem Briefkasten.
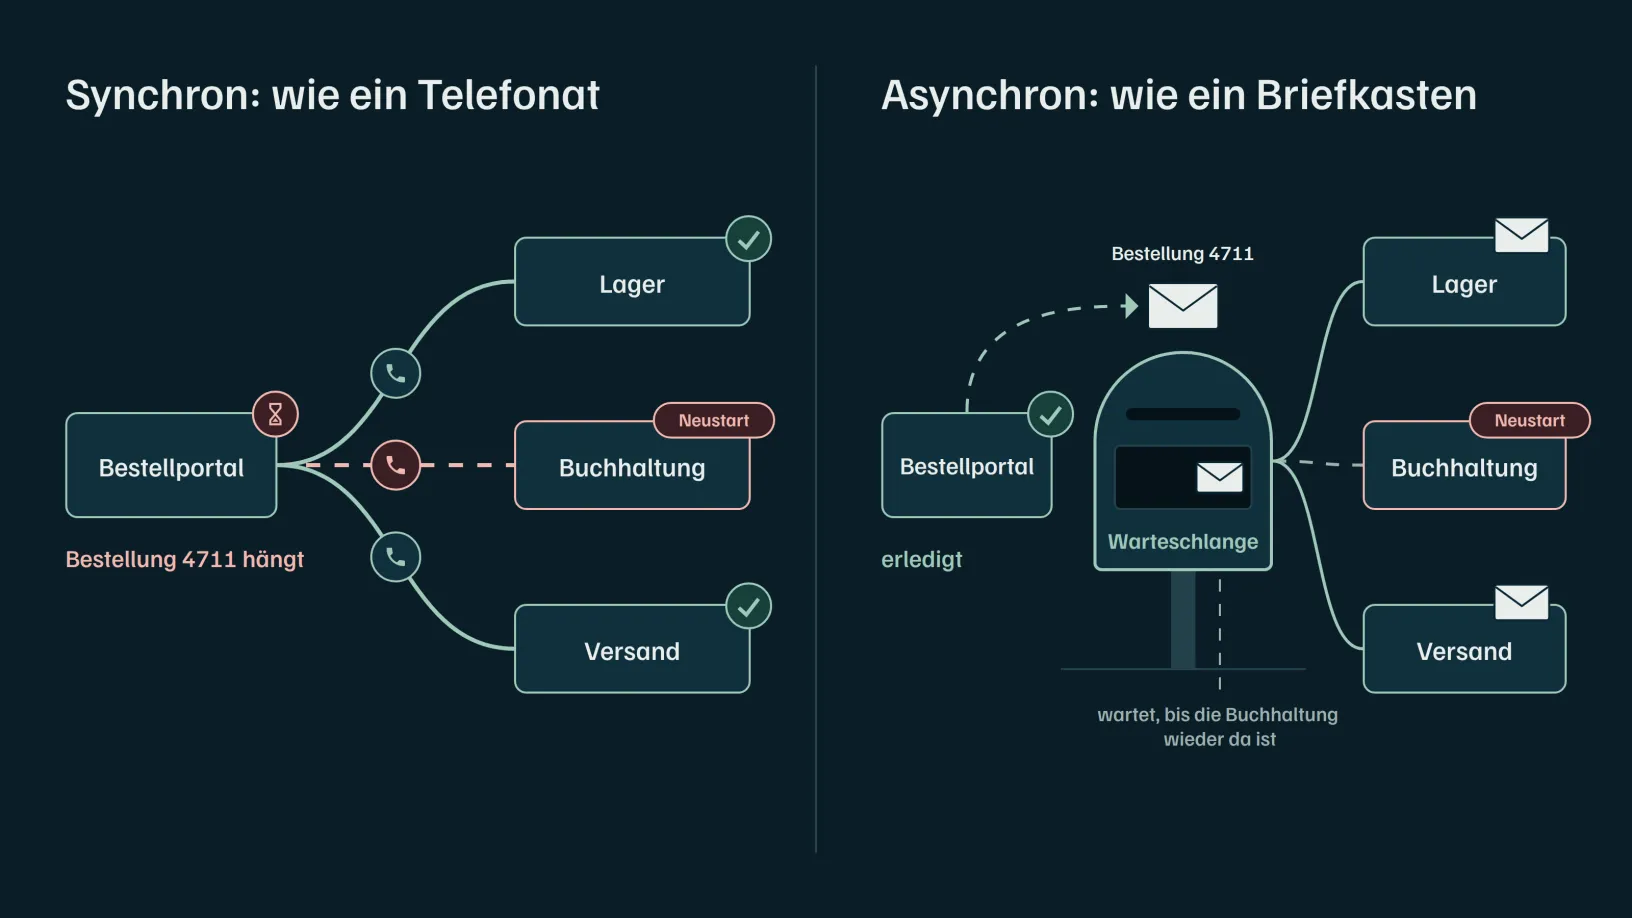
Ein Beispiel: Ein neuer Transportauftrag soll in die Tourenplanung, in die Abrechnung und an das Lager. Ruft das Portal alle drei direkt auf und die Abrechnung startet gerade neu, hängt der Auftrag. Liegt die Nachricht in einer Warteschlange, wartet sie dort, bis die Abrechnung wieder da ist. Das Portal muss davon nichts wissen.
Schlechte Kommunikationsmuster koppeln Systeme eng aneinander und machen die Wartung schwer. Im Mittelstand wird das schnell teuer: Wer jedes System mit jedem verbindet, hat bei 20 Systemen 190 mögliche Verbindungen. White Veil Industries schätzt, dass die Pflege solcher Integrationen 15 bis 25 % des IT-Budgets frisst. Ein zentraler Knoten, über den alle reden (Hub-and-Spoke), hält das überschaubar.
So entscheidest du dich
Die Frage ist nicht, welcher Transport der beste ist, sondern wer am anderen Ende sitzt.
flowchart TD
    A{"Wer ruft die Schnittstelle auf?"}
    A -->|"Partner, Kunden, fremde Software"| B{"Gibt die Gegenseite SOAP vor?"}
    B -->|"Ja"| SOAP["SOAP"]
    B -->|"Nein"| REST["REST mit OpenAPI-Beschreibung"]
    A -->|"Eigene Apps und Frontends"| D{"Mehrere Apps mit unterschiedlichem Datenbedarf?"}
    D -->|"Ja"| GQL["GraphQL"]
    D -->|"Nein"| C{"Nutzt das Frontend den TypeScript-Code des Servers mit?"}
    C -->|"Ja"| TRPC["tRPC"]
    C -->|"Nein"| REST
    A -->|"Eigene Dienste untereinander"| E{"Muss die Antwort sofort da sein?"}
    E -->|"Nein"| QUEUE["Warteschlange oder Events"]
    E -->|"Ja"| F{"Viele kleine Aufrufe unter hoher Last?"}
    F -->|"Ja"| GRPC["gRPC"]
F -->|"Nein"| REST„REST mit Beschreibung“ heißt: Zur Schnittstelle gehört eine maschinenlesbare Beschreibung, meist im Format OpenAPI. Darin steht jede Adresse, jedes Feld und jeder Fehlercode. Das fremde Team liest daraus die Doku und kann sich den Code für seine Seite erzeugen lassen, ohne je euren Code zu sehen. Am anderen Ende kann inzwischen auch ein KI-Assistent sitzen. Wie der eine bestehende REST-API nutzt, steht im Artikel über MCP.
Und warum nicht GraphQL, das sich ja selbst beschreibt? Ginge auch. Aber der Versandhändler will Aufträge anlegen und den Sendungsstatus abfragen, nicht frei Daten zusammenstellen. Dafür ist REST das, was ein fremdes Team mit großer Wahrscheinlichkeit schon kann.
Mischen ist dabei normal und oft richtig. Die Spedition muss ihr Portal nicht umbauen. tRPC bleibt zwischen Portal und Server, wo es wenig Code braucht. Für den Versandhändler kommt eine REST-Schnittstelle mit OpenAPI-Beschreibung dazu. Tourenplanung und Abrechnung bekommen ihre Nachrichten über eine Warteschlange.
Diese Fehlgriffe begegnen uns am häufigsten:
- Eine interne Schnittstelle (tRPC oder ein internes GraphQL) wird später für Partner geöffnet, ohne dafür gebaut zu sein.
- GraphQL für ein einziges Frontend mit überschaubaren Daten: viel Werkzeug für wenig Gewinn.
- gRPC, weil es schneller ist, obwohl die Last das nie verlangt.
- Alles synchron verdrahtet, wo eine Nachricht auch warten könnte.
Frag beim nächsten Projektstart deshalb nicht zuerst „REST oder GraphQL?“. Frag: „Wer soll diese Schnittstelle in drei Jahren aufrufen?“ Hat darauf niemand eine Antwort, ist es für die Technik noch zu früh.
- Architektur
- Bestandssysteme
Artikel teilen
LinkedIn ↗